AI検索くん 公式Guide
robots.txtとは?検索エンジンのクロールを制御する仕組み
robots.txtの役割と誤解しやすい点を解説。クロール制御と検索結果からの非表示は別物であることを説明します。
robots.txtはサイトの入口に置くルール表
通常はドメイン直下の/robots.txtに置き、User-agentやDisallowなどでクローラーのアクセス範囲を伝えます。主な用途はクロールトラフィックの管理です。
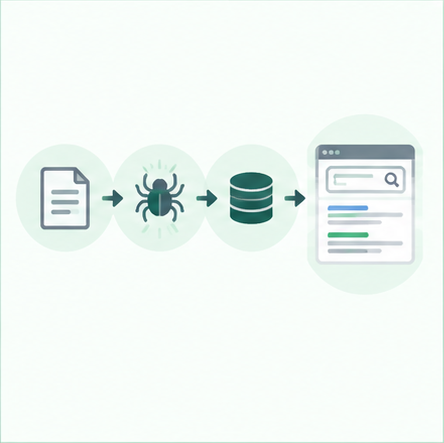
「Disallow=検索結果から消える」ではない
Googleは、robots.txtでクロールを禁止したURLでも、外部リンクなどからURLを発見して検索結果にURLだけ表示する可能性があると説明しています。検索結果から確実に除外したい目的にはnoindexや認証など別の方法を使います。
CSSやJavaScriptをむやみに塞がない
ページを理解・表示するために必要なリソースまでブロックすると、検索エンジンがページを正しく把握しにくくなる場合があります。理由の分からないDisallowをコピーしないことが大切です。
AI検索のクローラーは別に確認する
OpenAIはChatGPT検索のためのOAI-SearchBotについて案内しています。GooglebotとOAI-SearchBotは別のクローラーなので、AI検索を確認する場合は対象ごとの設定を見ます。
知識だけで終わらせず、自店の状況を確認する。
AI検索くんでは、AI検索での紹介状況、Googleマップ、Google検索の状況を継続して確認し、店舗集客の改善に取り組めます。この記事で基本を理解したら、実際の自店の状態と照らし合わせてみましょう。
AI検索くんについて見る参考にした公式情報
検索・AI・Googleビジネスプロフィール等の仕様は変更されることがあります。本記事は2026年10月5日時点で確認した公式情報を基準にしています。個別の掲載・順位・改善効果を保証するものではありません。